課題
Mac専用のAI画像生成ツール「DiffusionBee」は、開発がほぼ止まっている。最新の高品質Model「FLUX」には画像生成では対応しているが、実はもう1つ「Video Tools」という動画・アニメーション機能も持っている。ただしこの機能自体は2023年に追加されたもので、今の技術基準からすると古い実装になる。
「古いツールでも、今の高品質なAI画像生成と組み合わせれば、質の高いアニメーションが作れるのではないか」という仮説が浮かび、実際に試してみることにした。
解決できるようにすること
DiffusionBeeのVideo Tools(今回は「Interpolator」という、開始と終了の状態を指定して間を補間する機能を使用)が、今の高品質なAI画像生成の恩恵をどこまで受けられるのかを、段階的な検証で明らかにする。
先に結論
結論は、単純な「できる」「できない」では言い切れないものになった。最新Model(FLUX)には技術的に対応しておらず、これは確定した限界になる。一方、対応しているModelの範囲内では、Promptの書き方次第で安定度が大きく変わり、しかも「厳密に書けば書くほど安定する」という単純な話でもなかった。Style語を強く固定すると別の要素が上書きされたり、衣装の装飾が多いと衣装だけが選択的に崩れたりと、崩れ方そのものが条件によって変わることが分かった。
この記事でわかること
- DiffusionBeeのVideo Toolsが、最新Modelにどこまで対応しているか
- Promptの厳密さと生成の安定性が、単純な比例関係ではないこと
- 同一性の崩れが、なぜ・どこに集中して起きるのか
前作のおさらい
以前、DiffusionBeeのInpainting機能を試した記事を書いた。今回はその続きとして、まだ触れていなかった「Video Tools」を対象にする。
まずFLUXが使えるか確認した
DiffusionBeeのHome画面には、「Interpolator」(PromptとSeedを補間して動画を作る)と「Deforum Video」(Promptを時系列で切り替えて動画を作る)という2つのVideo Toolsがある。どちらの画面にもModelを選ぶ欄があり、単独の画像生成Tool「Flux」で使える最新Model「FLUX.1-schnell」が、ここでも選べるのではないかと考えた。
FLUX.1-schnellをダウンロードし、Flux Tool側では問題なく使えることを確認した。ところが、Interpolatorの画面でModelの選択肢を開いてみると、ダウンロード済みのはずのFLUX.1-schnellが一覧に出てこなかった。
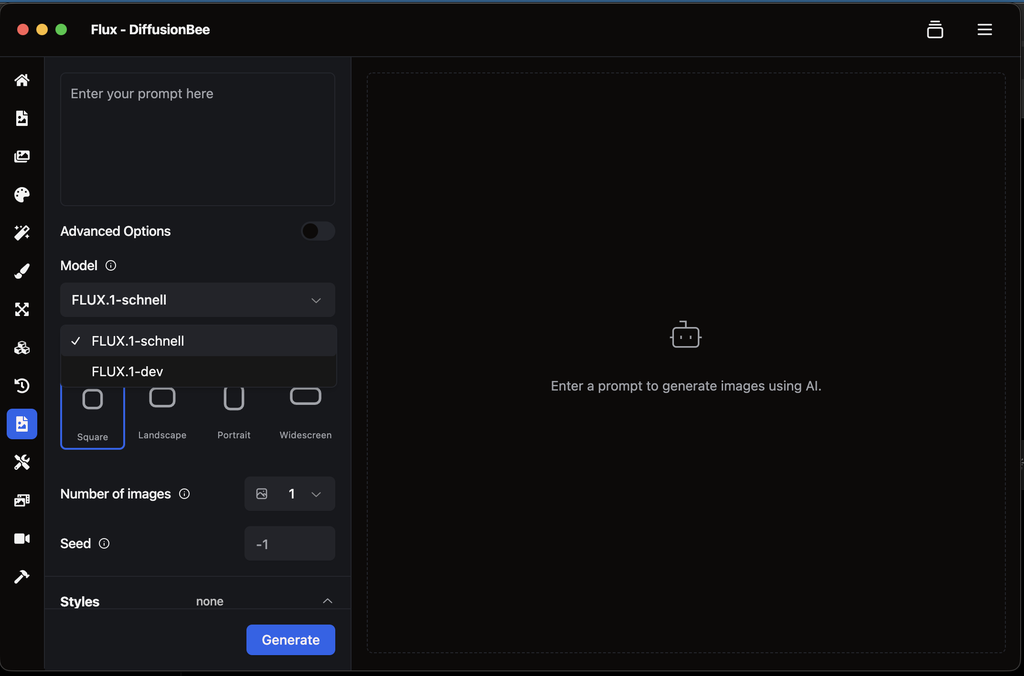
調べてみると、Video Tools自体は2023年6月に追加された機能で、FLUXへの対応が入ったのは2024年8月と、1年以上後になる。つまりVideo Toolsは、実装の都合上、最新のModelアーキテクチャに対応できていないと判断できる。
こう思う人もいるかもしれない。
「最新Modelが使えないなら、この機能自体もう終わっているのでは?」
そうとも言い切れない。ダウンロード済みのModelの中には、今回使う「animagineXLV31」のような、比較的新しく実用性の高いModelも含まれている。最新Modelには対応していないが、対応Modelの範囲内でどこまでできるかを、次の段階で検証した。
大雑把なPromptで試したら「別人」になった
Model「animagineXLV31」を使い、Interpolatorで「立っている・落ち着いた表情」から「腕を上げて笑っている」への変化を試した。Start SeedとEnd Seedは同じ値に固定した。Promptは1girl, standing, simple pose, calm expressionのような大まかなTag列挙にした。
結果、Seedを固定したにもかかわらず、40Frameの中で髪型がストレートから途中でツインテールへ変わり、また別の髪型に変わり、服装もオーバーオールからタンクトップへ変化した。腕を上げた終盤のFrameでは、腕の陰影も不自然になっていた。
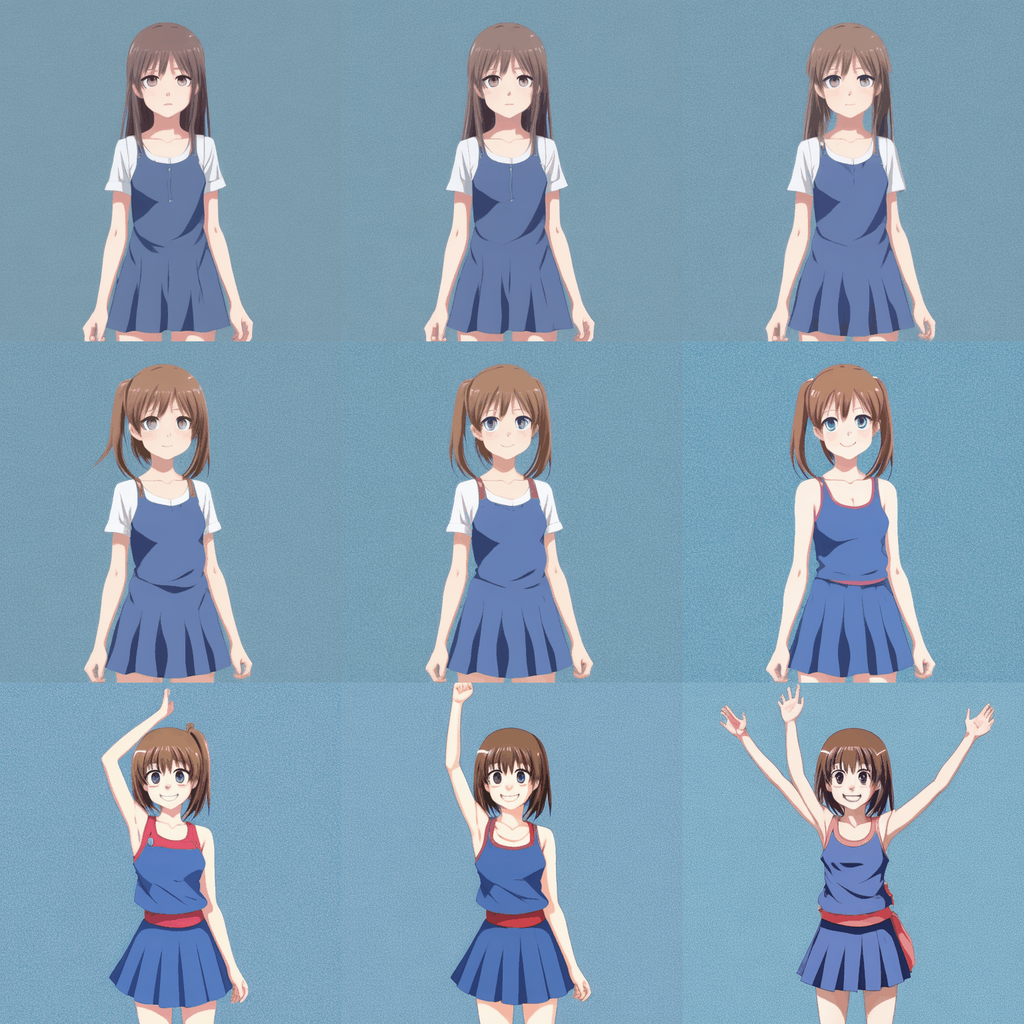
同じSeedを指定しても、Promptが大まかだと、Model側の解釈の自由度が広すぎて同一性を保てないと分かった。
Promptを厳密にしたら、小さな変化なら安定した
そこで、Promptを大幅に見直した。髪型・髪色・服装・背景を一言一句同じ文言でStart/End両方に固定し、変化させるのは表情だけに絞った。さらに「別の髪型・別の服・別の髪色への変化」を明示的に禁止するNegative Promptも追加した。
結果は一変した。40Frame全体を通して髪型・服装・背景が完全に安定し、表情だけが真剣な表情から自然な笑顔まで滑らかに変化した。
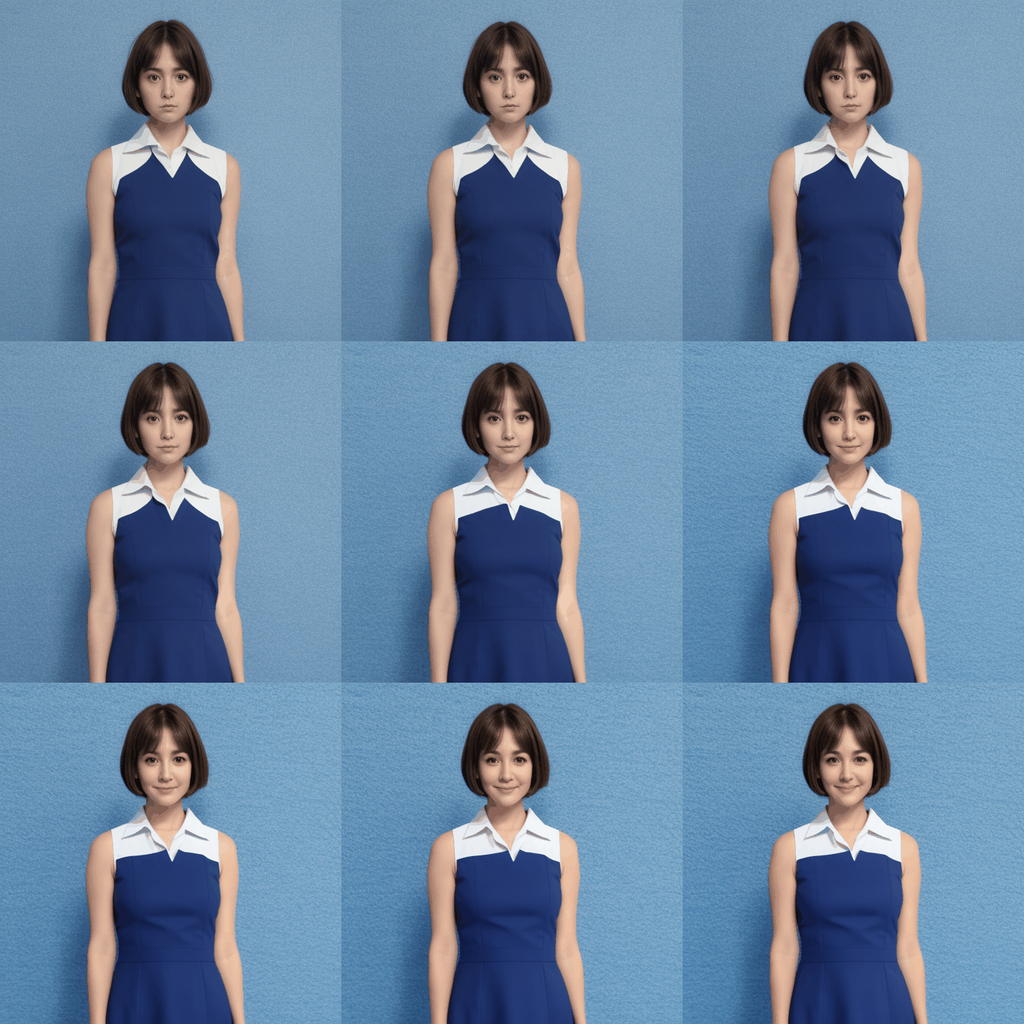
ただし、後で気づいたことがある。胴体部分を拡大して比較したところ、襟が肩を覆う面積とネックラインの深さが、Frameを追うごとにわずかに変化していた。「完全に安定」と評価したのは言い過ぎで、大崩れはしないが完全固定でもない、というのが正確な状態だった。
さらに厳密にしたら、今度は別の要素が崩れた
襟・ネックラインの範囲まで具体的に固定するPromptに書き直したところ、服装のドリフトは解消した。ところが、指定していなかった2つの要素で意図しない結果が出た。
1つは背景。「plain light blue background(プレーンな薄い青の背景)」と指定したのに、実際は質感のあるコンクリートブロック壁と、方向のある影が写り込んでいた。もう1つはStyle。Promptにはanime screencap styleを含めていたのに、出力は完全に写実的な画像になっていた。
「あれ、Anime指定したはずなのに、写真みたいになっているぞ」というのが正直な感想だった。服装を細かく英語で描写したことで、Anime Style側の指定が埋もれてしまったと考えられる。
Anime Styleを強く固定したら、意外な連想が起きた
今度はAnime Styleを強く固定するため、Prompt先頭にCel Shading等のStyle語を追加し、Modelも別のAnime特化Model「AnythingXL_xl」に変更した。体格・顔立ちも具体的な語で固定した。
結果、Anime Styleの固定と、体格・顔の同一性は非常に高いレベルで安定した。ところが、今度は別の3つの意図しない結果が生じた。
- Start(真剣な表情)からEnd(笑顔)への表情変化が、最後のFrameまで一切反映されなかった
- 服の色が指定した青から、水色寄りのセーラー服に変わり、指定していない白いリボンまで追加された
- 背景が指定した「プレーンな薄い青」から、和室・障子のような背景に変わった
Promptに含めていた「セーラーカラー」という語と、強いAnime Style語の組み合わせが、Model内部にある「アニメの女学生+和室」という強い連想を呼び起こし、色・背景・表情変化という複数の指定を上書きしてしまったと考えられる。
装飾の多い衣装で試したら、そこだけが崩れた
最後に、上着・ネクタイ・肩から掛けたベルト・星型の飾り・縁取り模様など、装飾要素の多い衣装デザインを対象に、これまでに確立した手法(厳密なPrompt・Negative Prompt・体格固定・同一Seed)を適用した。Number of framesは30に変更した。
結果、髪型・髪色・顔立ちは比較的安定していた一方、衣装だけが30Frame全体を通して激しく崩壊した。配色・飾りの形と位置・縁取り模様が、Frameごとにほぼ別の衣装に見えるほど変化していた。
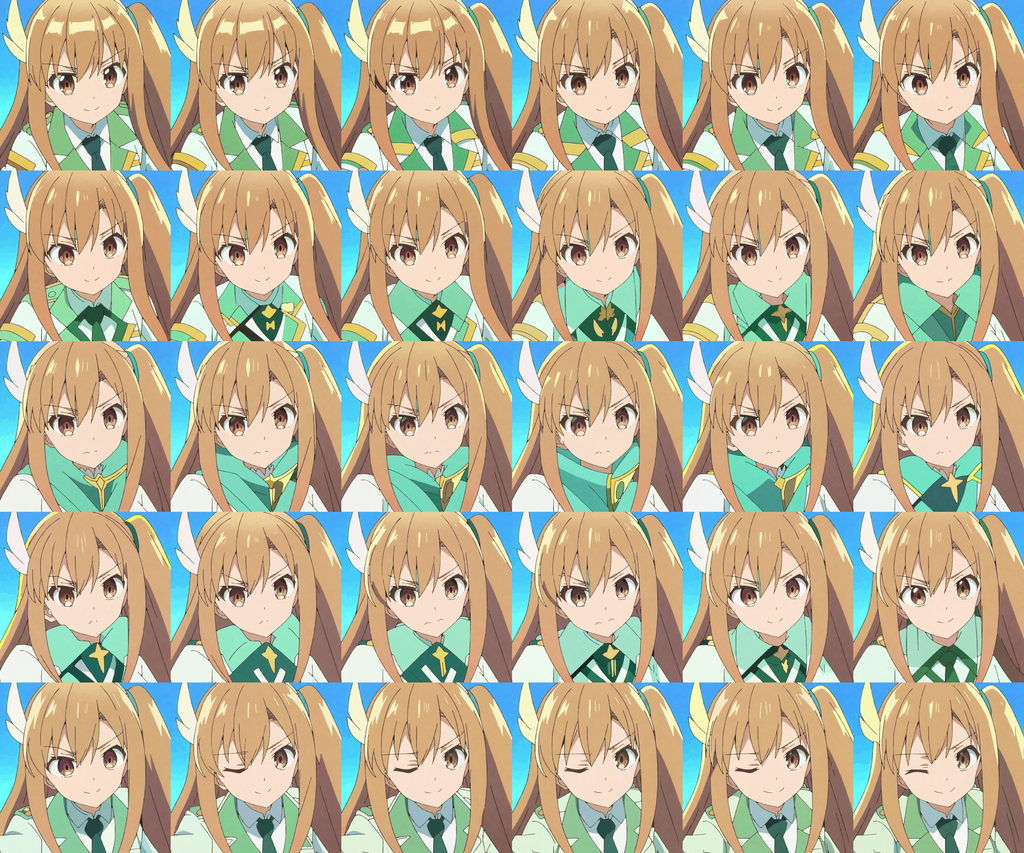
無地のワンピースのような単純な衣装では同じ手法で安定していたのに対し、装飾要素が増えると同じ厳密さのPromptでも崩れやすくなる。同一性の崩壊は全身が均等に起こるのではなく、複雑な部位に集中する傾向があると分かった。
気づいたこと
- DiffusionBeeのVideo Toolsは、実装時期の都合でFLUX等の最新Modelアーキテクチャには対応していない
- 対応Modelの範囲内でも、Promptが大まかだと同一Seedを指定しても同一性は保てない
- Promptを厳密にするほど安定するとは限らない。Style語を強く固定すると、別の要素(背景・色・表情の変化そのもの)が上書きされることがある
- 同一性の崩壊は全身が均等に起こるのではなく、衣装の装飾数のような複雑さに応じて特定の部位に集中する
- 小さな変化(表情のみ)には、Number of framesを多めに設定しても、再生速度を上げると違いがほとんど分からなくなる。フレーム数自体が過剰だった可能性がある
こんな人に向いている
DiffusionBeeのVideo Toolsで「今のAI画像生成の質」をそのまま活かせると期待している人は、最新Modelに対応していない時点で、期待値を調整した方がいい。
一方、「対応Modelの範囲内で、どこまでの表現なら安定するか」を知りたい人には、今回の段階的な検証が参考になる。変化を小さく絞り、変化させない要素をPromptで厳密に固定するほど安定しやすいが、Style語の強さや衣装の複雑さによっては、それでも崩れる場合があるという前提を持っておくとよい。
まとめ
| 項目 | 内容 |
|---|---|
| 結論 | 最新Model(FLUX)には非対応。対応Model内でも、Promptの厳密さと安定性は単純な比例関係ではなく、Style語の強さや衣装の複雑さによって崩れ方が変わる |
| 教訓 | 「今の技術を組み合わせれば質が上がる」という単純な仮説は成立しなかった。何が・なぜ崩れるかを段階的に切り分けることで、実用可能な範囲が見えてくる |
| 対象読者 | DiffusionBeeのVideo Toolsを試したい人、AI画像生成のPrompt設計で同一性を保ちたい人 |
同じ状況に陥ったときの回避策
- Video Tools(Interpolator・Deforum Video)でModelを選ぶ前に、目的のModelがそもそも一覧に出るかを確認する(DLしても出ない場合がある)
- 同一性を保ちたいときは、変化させない要素をStart/End Promptへ一言一句同じ文言で固定し、Negative Promptで変化を明示的に禁止する
- 変化は小さく絞る。大きな変化を一度に要求すると崩れやすい
- Style語を強く固定した場合は、Model内部の強い連想(Archetype)が他の指定を上書きしていないか、出力を必ず確認する
- 装飾要素の多い衣装・デザインを対象にする場合は、単純なデザインより崩れやすいことを前提に検証する
公式Source・運営者情報
この記事は、DiffusionBeeの実践記録(2026年9月14日〜18日)を基に、独自調整したAIが下書きを作成し、筆者が事実確認・編集を行った上で公開しています。