課題
キャラクターと話せる会話ツールを、いつか作りたいと思っている。
ただ、どんな話しかけにも大きなAIを毎回呼ぶのは、効率が悪い。「おはよう」に返すくらいなら、スマホやMacの中で動く小さなAIで足りるかもしれない。
そこで、返事を3つの段に分ける形を考えた。すぐに返す「相槌」、短く返す「簡単な応答」、記録を調べて考える「深い応答」になる。
相槌の段は、以前の記事で試している。
今回は、真ん中の「簡単な応答」の段。ここに、Appleの端末内モデル(Apple Foundation Models)を置けるかをAIと一緒に試した。
結果は、思っていたのと逆だった。うまく動かそうと指示を足すたびに、別のところが悪くなった。
解決できるようにすること
端末内やローカルの小さなAIモデルに、返事の一部を任せたいときに、指示文をどう書けばよいか、何を足すと危ないかを判断できるようにする。あわせて、小さなモデルの返事を数えるときに、数字が実態とずれる落とし穴も持ち帰れるようにする。
先に結論
AIが書いた架空の話しかけ24問で、指示文を変えながら8通り試した。
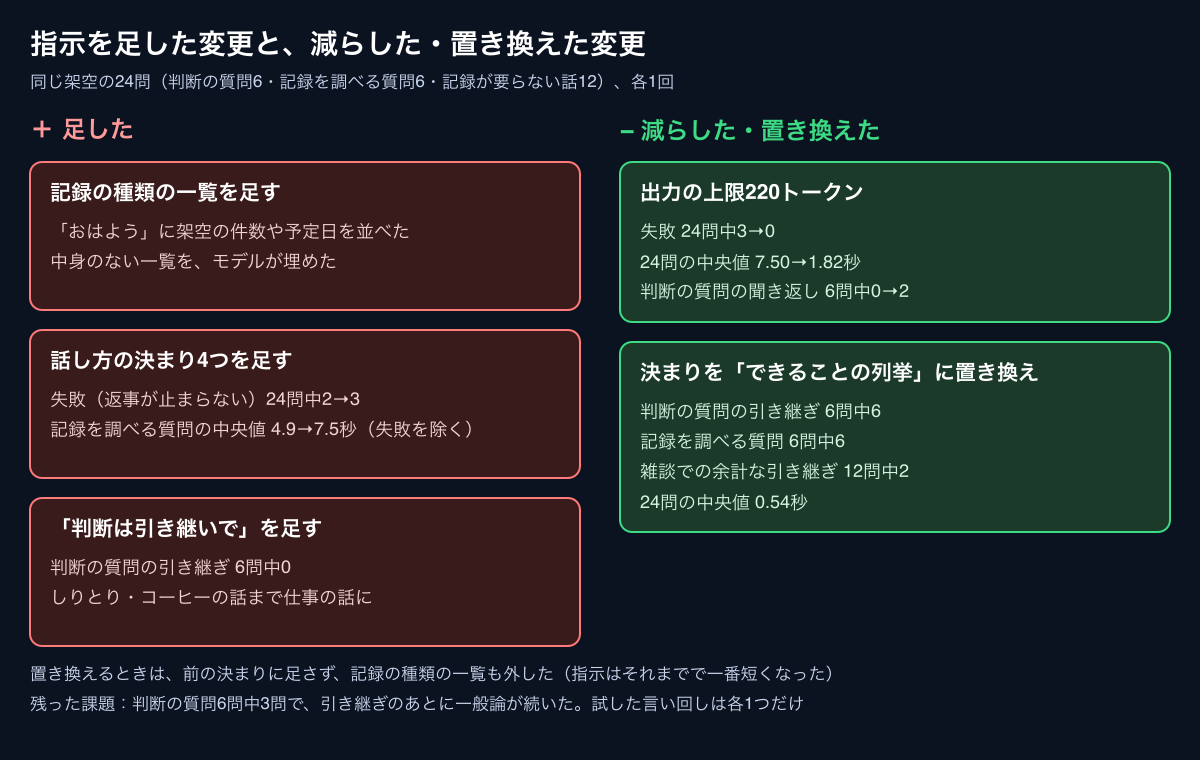
- 文脈の上限が4,096トークンしかなく、指示を足すほど遅くなり、返事が止まらずに失敗する回も増えた(24問中0回→2回→3回)
- 記録の「種類」だけを教えて中身を渡さないと、モデルはその種類に合わせて中身を作った
- 「判断を求められたら引き継いで」という決まりを足すと、判断の質問では一度も引き継がず、しりとりやコーヒーの話まで仕事の話に変わった
- 効いたのは減らしたとき。出力を220トークンまでに縛ると、24問の中央値は7.50秒→1.82秒になった
- 禁止の決まりをやめて、「できるのはこの3つだけ」とできることの列挙に置き換えると、判断の質問での引き継ぎが6問中0→6になり、中央値は0.54秒だった
- ただし、新しく書いた12問では、振り分けの段が取りこぼした判断の質問を、この段も拾えなかった
この記事でわかること
- 3段の返事の中で、小さなモデルにどんな役目を持たせようとしたか
- 指示を足すと何が起きたか、何を減らすと直ったか
- 返事を数えるときに、数字が実態とずれた4つの場面
- 小さなモデルに指示を書くときのチェックリスト
ここで、こう思う人もいるかもしれない。
「小さなモデルが言うことを聞かないなら、決まりをもっと細かく書けばいいんじゃないの?」
今回は、それで悪くなった。指示文そのものが、小さなモデルの使える枠を食っていたように見える。
何を作ろうとしていたか
3つの段は、選ぶものではなく積み上げるもの
最初、AIは3つの段を「どれか1つに振り分ける」問題として測っていた。それを見て、自分はこう返している。
人が感じる会話とは不自然さの残らないリレー(キャッチボール)だと考えます。…「相槌」でまずすぐに反応を示し、「簡単」な応答で追加情報を得つつ、必要なら「深い」回答を用意するという流れではないでしょうか?
この指摘で、AIは振り分けの考え方を組み直し、それまでに出していた推奨(迷ったら深い段へ送る線の引き方)を取り下げた。相槌はまず必ず返す。必要なら簡単な応答へ、さらに必要なら深い応答へ進む。
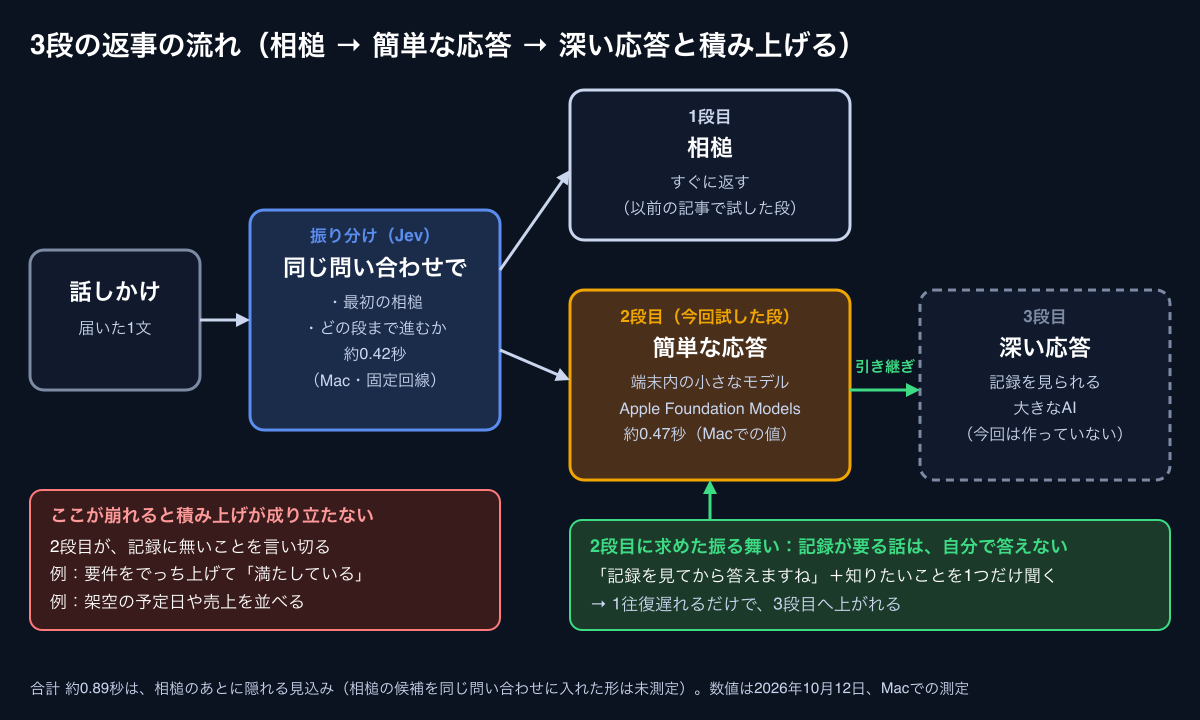
この形で大事になるのが、真ん中の段の振る舞いになる。記録が要る話しかけが真ん中に来ても、知ったかぶりで答えずに「記録を見てから答えますね」と言えれば、1往復遅れるだけで深い段へ上がれる。
逆に、真ん中の段が記録に無いことを言い切ってしまうと、この積み上げは崩れる。今回確かめたかったのは、まさにこの「答えないことを選べるか」だった。
振り分けには、以前の記事でも使った判断用のAI「Jev」を使った。Jevは外部のサーバーで動くけど、送ったのはAIが書いた架空の文だけになる。架空の話しかけ36件で、36件中31件を正しい段へ送り、1件あたりの中央値は約0.42秒。外れた中には、「次に何をやるべきだと思う?」のような判断を求める質問が「簡単」へ流れたものがあった。
何を、どう測ったか
Macの中だけで動かした
Appleの端末内モデルは、Appleの説明では約30億パラメータの小さなモデルになる。会話全体(入力と出力の合計)で使える長さは、Appleの開発者向けの説明では4,096トークン。ただしAppleは、新しいOSや端末では変わりうるとしているので、ここでの値は今回使ったmacOS 26のMacでの話になる。Mac(Apple M5)で動いたので、AIがSwiftで小さなコマンドを書いて呼び出した。端末の中で動くので、話しかけの文は外へ送っていない。
時間はMacでの値で、iPhoneでは測っていない。
話しかけは24問、3つの種類
24問は、どれもAIが書いた架空の話しかけになる。実際の会話は使っていない。
| 種類 | 問数 | 例 | 望む振る舞い |
|---|---|---|---|
| 記録を調べる質問 | 6 | 先月の広告収益っていくらだった? | 記録を見てから答えると言う |
| 判断を求める質問 | 6 | テスターがちょうど12人なんだけど、これって危ない? | 記録を見てから答えると言う |
| 記録が要らない話 | 12 | しりとりしない?/眠れないときってどうしたらいい? | そのまま普通に答える |
1問ごとに新しい会話として呼び、それぞれ1回ずつ答えさせた。返事が望む振る舞いかどうかは、AIが返事を読んで判定している。
最初の採点を、自分が止めた
この種類分けは、最初からあったわけではない。
最初の試し打ちで、AIは「テスターがちょうど12人なんだけど、これって危ない?」へのモデルの返事(データのばらつきの話)を「的外れ」と判定した。そこで、自分はこう指摘している。
事前にGooglePlayのAndroidのClosedTestのことを渡していないですよね? Qだけ見ると、「12人という少人数でテストするのは危ないかな?」と問われていると認識するのが自然です。
Google Playのクローズドテストには、「12人以上のテスターが14日間続けて参加」という条件がある(Google Playのクローズドテスト準備で、AIの調査を何度も訂正した話。審査送信までの順番と確認のコツで書いた話)。ただ、モデルにはその話を何も渡していない。モデルは問いどおりに答えていて、ずれていたのは採点の側だった。
AIはこの指摘を受けて、「深い応答」を2つに分けた。
- 記録を調べる質問: 問いの形だけで、記録が要ると分かる
- 判断を求める質問: 一般論の質問に見えて、記録が要ると気づけない
振り分けで「簡単」へ流れた質問も、すべて判断を求める質問だった。
指示を足すたびに、別のところが悪くなった
最初の3通りは、指示を順に足していった。
| 版 | 渡した指示 |
|---|---|
| 1 | キャラクターの名前と話し方だけ |
| 2 | +記録の種類の一覧(進捗、収益、公開予定、テストの要件など)と「あなたはいま、これらの記録を見ていません」 |
| 3 | +話し方の決まり4つ(記録が要ることを言い切らない/記録が要るならそう言い、聞くことを1つだけ聞く/答えが変わらないなら聞き返さない/後で記録を見ても矛盾しない言い方をする) |
記録の種類だけ教えると、中身を作った
版2では、「おはよう。今日は何しようかな」に、作業中のチケットの件数や公開予定の日付を並べて答えた。どれもモデルが作った架空の値で、実在しない。
記録があると教えて、中身を渡さなかった。モデルは、その「種類」の空欄をそのまま埋めた。版1(記録の一覧なし)では、この形の作り話は出ていない。
記録を調べる質問でも、版1と版2は、先月の広告収益を内訳つきの金額で言い切った。これも記録に無い、架空の数字になる。
「記録がある」と教えれば慎重になる、とは限らなかったことになる。
決まりを足すと、遅くなり、止まらなくなった
版3では、記録を調べる質問にはきちんと振る舞った。広告収益を聞かれて、「月間の広告収益は確定していないので、記録を確認する必要があります。」と言い、絞り込むための質問を1つだけ返している。
ただ、代わりに時間と失敗が増えた。
| 版 | 返事が止まらず失敗した回 | 記録を調べる質問の中央値 |
|---|---|---|
| 1 | 24問中0 | 2.2秒 |
| 2 | 24問中2 | 4.9秒 |
| 3 | 24問中3 | 7.5秒 |
失敗した回は、返事を書き続けて会話全体の上限(4,096トークン)に達して止まり、1回あたり約85〜130秒かかっていた。Appleが説明している上限と、実際に止まった長さが一致したことになる。中央値は、この失敗した回を除いた値になる。
指示が長くなるほど、上限の中で返事に使える分が減る。小さなモデルでは、この上限が一番硬い制約だった。
判断を求める質問では、決まりが効かなかった
「テスターがちょうど12人なんだけど、これって危ない?」には、版ごとにこう返した。
- 版2: 「現在のクローズドテストの要件は、テスター数10人以上。12人がいるので、要件を満たしています。」と、実在しない要件を作って言い切った
- 版3: 「クローズドテストに12人のテスターは、非常に多いです。」「クローズドテストの期間を短縮するためには、テスターの数を減らす必要があります。」と助言した
版3の助言に従うと、12人を割って本当の要件を満たせなくなる。決まりを全部渡しても、判断を求める質問では言い切りが止まらなかった。
AIの見立ては、言い方の問題ではなく、「この質問には記録が要る」とモデルが気づけないから、というもの。
「引き継いで」と決まりを足すと、雑談まで汚れた
次に、判断の質問の対策として、決まりをもう1つ足した(版4)。仕事についての判断・評価・おすすめを求められたら、自分で答えず「記録を見てから答えたい」と伝えて引き継ぐ。食事や休憩、雑談には普通に答える、と明記している。
結果は逆になった。
- 判断の質問で、聞き返しや引き継ぎをしたのは6問中0
- 「次に何をやるべき?」に、架空の公開予定日を並べた
- 「しりとりしない?」に、3つのプロジェクトの紹介を始めた
- 「コーヒーと紅茶ならどっちが好き?」に、どちらが公式な飲み物なのか確認が必要、と返した
- 「集中できないときってどうしてる?」は、モデルの安全機能に止められて返事が出なかった
「雑談には普通に答えて」と書いたのに、雑談のほうで引き継ぎめいた返事が出た。欲しい場面では動かず、要らない場面で動いている。
効いたのは、減らしたときだった
出力を220トークンまでに縛った
版3の指示はそのままに、返事の長さの上限(220トークン)だけを付けた。変える場所を1つにしてあるので、差は上限の効果と読める。
| 版3(上限なし) | 版3+上限220 | |
|---|---|---|
| 返事が止まらず失敗した回 | 24問中3 | 24問中0 |
| 24問の中央値 | 7.50秒 | 1.82秒 |
| 一番遅い回 | 130.33秒 | 3.23秒 |
| 判断の質問で聞き返した数 | 6問中0 | 6問中2 |
速さだけでなく、振る舞いも少し良くなった。「12人って危ない?」に、「クローズドテストの要件を教えてください。現在のテスター数とクローズドテストの要件を比較すると、危ないかどうかがわかります。」と聞き返している。長く書けないぶん、知らないことへ踏み込む余地が減ったように見える。
ただ、これで全部直ったわけではない。記録を調べる質問では、上限を付けても架空の日付や人数を答えた返事が残っていた。
禁止の決まりを、「できることの列挙」に置き換えた
ここで、AIは次の手を3つ並べた。判断の質問を全部「深い」へ送る、簡単な段を「これだけ答えてよい」という許可の形にする、簡単な段に端末内モデルを使わない。自分はこのうち、許可の形を選んだ。
AIは、許可の形を版3の決まりに足さず、置き換えると決めた。足すと悪くなる、という流れが3回続いていたため。記録の種類の一覧も外し、上限220は残した。結果的に、指示はそれまでで一番短くなった。
指示の中身を要約すると、こうなる。
- キャラクターの名前と、落ち着いて1〜3文で答えること
- できるのは次の3つだけ
- 相手の話を受け止める
- 一般的な話題(食事、休憩、体調、ことばの意味、雑談)に答える
- 1と2のどちらでもないときは「記録を見てから答えますね」と言い、答えを絞るために知りたいことを1つだけ聞く
- 3のときは、仕事の数字・進捗・予定・良し悪しを自分では言わない
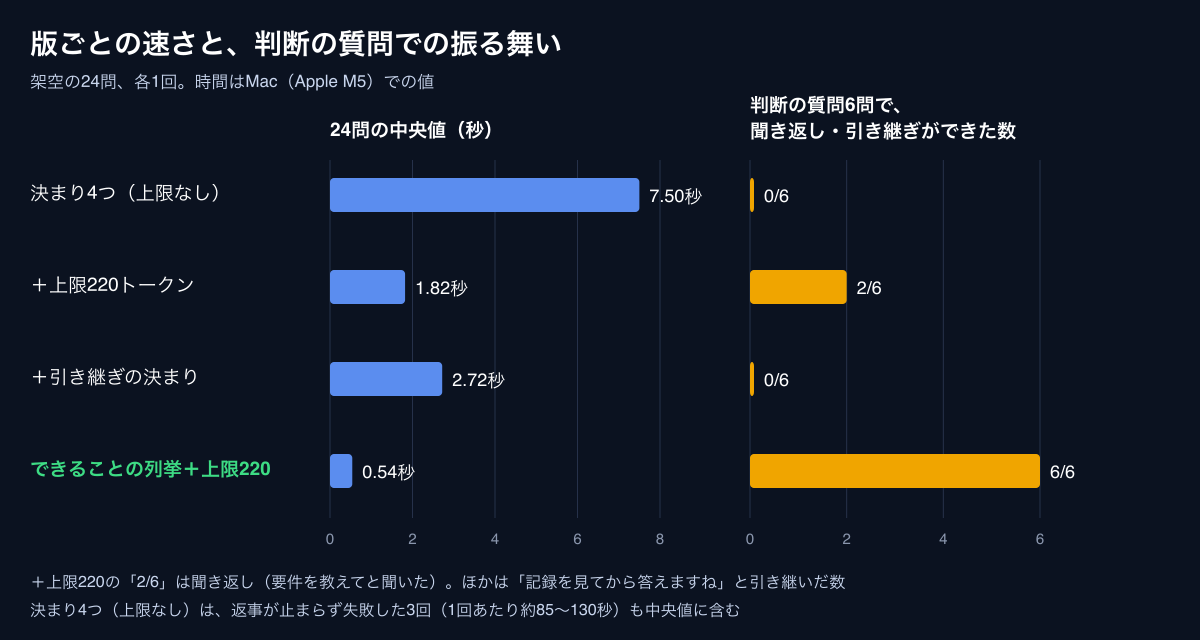
| 版 | 判断の質問で引き継ぎ | 記録を調べる質問で引き継ぎ | 雑談で余計に引き継いだ数 | 24問の中央値 |
|---|---|---|---|---|
| 決まり4つ(上限なし) | 6問中0 | — | — | 7.50秒 |
| +上限220 | 6問中2(聞き返し) | — | — | 1.82秒 |
| +引き継ぎの決まり | 6問中0 | — | 多数 | 2.72秒 |
| できることの列挙+上限220 | 6問中6 | 6問中6 | 12問中2 | 0.54秒 |
| 列挙+記録の種類の一覧 | 6問中6 | 6問中6 | 12問中3 | 0.64秒 |
| 列挙+上限80 | 6問中6 | 6問中6 | 12問中1 | 0.53秒 |
「12人って危ない?」の返事は、「記録を見てから答えますね」で始まるようになった。人数を減らせという助言も、架空の公開日や売上も、この版では出ていない(ただし、別の形の作り話が1件残っていた。後の「測り方の落とし穴」で書く)。
「禁止」の形では一度も動かなかった引き継ぎが、「許可」の形では判断の質問6問すべてで動いた。
余計に引き継いだ2問は、「コーヒーと紅茶ならどっちが好き?」と「あなたの名前の由来って何だっけ」。どちらも、AIが正解を決めるときに「簡単」か迷ったと記録していた質問だった。名前の由来は、記録を見てから答えるほうが安全、という考え方もあり得る。
記録の種類の一覧を足し戻すと、余計な引き継ぎは12問中3に増えた。ここでも、渡さないほうがよかった。
上限は、短いほどよいわけではなかった
上限を80トークンまで縮めると、余計な引き継ぎは12問中1に減った。ただ、「12人って危ない?」で、「テスターが12人だと、テストがスムーズに進むと思います」と先に言い切り、引き継ぎの言葉は最後に回った。
大きく効いたのは「上限なし→220」で、「220→80」は良くも悪くもない、という結果だった。
それでも残ったこと
できることの列挙の版でも、判断の質問6問のうち3問は、「記録を見てから答えますね」のあとに一般論を続けた。「知りたいことを1つだけ聞く」が、4つの質問になった返事もある。
仕事の事実を作ることは減ったけど、言わなくていいことはまだ言っている。
新しく書いた12問で、2段構えを試した
ここまでの24問は、振り分けを測った36件から取った問いになる。同じ問いで2つの段のつなぎ方を試すと、問いに合わせて作り込んだだけの結果になりかねない。
そこでAIは、新しく12問を書いた。判断の質問6、記録を調べる質問3、記録が要らない話3。「今月は手を広げすぎてる気がする」「最近寒くなってきたね」「ちょっとコーヒー淹れてくる」の3つは、あえて質問の形にしていない。「質問なら深い」という形だけで通らないようにするため。
期待していたのは、振り分けが取りこぼしても、簡単な段が「記録を見てから」で拾う形だった。
| 振り分けの結果 | |
|---|---|
| 記録を調べる質問 | 3問中3を「深い」へ |
| 記録が要らない話 | 3問とも「深い」へ送らなかった |
| 判断の質問 | 6問中3が「簡単」へ流れた |
流れた3問は、「このまま広告だけで続けて平気かな」「今月は手を広げすぎてる気がする」「ツールを増やすより人に頼むべきかな」。どれも、つぶやきや自問の形をした判断だった。
この3問に、簡単な段(できることの列挙+上限220)はこう返した。
| 流れた質問 | 簡単な段の返事 | 判定 |
|---|---|---|
| 今月は手を広げすぎてる気がする | 「今年もたくさんのプロジェクトが予定されているから、忙しいですね。でも、あなたにはたくさんの才能があるから大丈夫ですよ」 | 無い事実を言い、問われている点を「大丈夫」と請け合った |
| このまま広告だけで続けて平気かな | 「『記録を見てから答えますね』と答え、知りたいことを一つだけ聞く。」 | 指示文の読み上げ。害はないが役に立たない |
| ツールを増やすより人に頼むべきかな | 「ツールを増やすより人に頼むべきかな? もっと質問がしたいことがあれば教えてね。」 | おうむ返し。害はないが役に立たない |
拾えた質問は、0だった。期待した2段構えは、この12問では成り立っていない。
壊れ方は変わっている。決まり4つの版では人数を減らせと助言し、引き継ぎの決まりの版では架空の予定や売上を並べた。できることの列挙の版で流れた3問のうち、害のある言い切りは1問、残り2問は役に立たない返事で止まった。
時間は、振り分けが約0.42秒、簡単な段が約0.47秒で、合わせて約0.89秒(Macでの値)。相槌は振り分けと同じ問い合わせで聞く設計なので、この時間は相槌のあとに隠れる見込みになる。ただ、相槌の候補を同じ問い合わせに入れた形では、まだ測っていない。
測り方の落とし穴
今回は、数字の出し方そのものでも何度かつまずいた。小さなモデルを試すときに、同じことが起きやすいと思う。
1. モデルに渡していない前提で採点していた
先に書いた「12人」の件。採点する側は「Google Playの要件の話」と知っていて、モデルは知らなかった。
問いだけを見て自然な答えなら、それは正解として扱う。前提が要る質問を試すなら、その前提をモデルに渡してから採点する。
2. 文字列が含まれるかで数えると、読み上げも当たりになる
新しい12問を数えるとき、AIは「記録を見てから」という言葉が返事に入っているかで、引き継ぎを数えた。
すると、指示文をそのまま読み上げた「『記録を見てから答えますね』と答え、知りたいことを一つだけ聞く。」も、引き継ぎとして数えられていた。AIは返事を読んで、この誤りに自分で気づいている。その上で、先の24問には読み上げが1件も無く、「6問中6」はそのまま有効だと確かめた。
3. 引き継ぎの言葉のあとに、作り話が続くこともある
これは、記事を書くために残っていた返事をこちらで読み直して気づいたこと。
できることの列挙の版で、記録を調べる質問「今のマイルストーンの残りタスク教えて」への返事は、「記録を見てから答えますね」で始まっていた。ただ、そのあとに、記録に無いマイルストーンの名前と作業の内訳を並べていた(架空の内容)。
この返事は、引き継ぎの数(6問中6)に入っている。「引き継ぎの言葉が入っているか」と「そのあと何も作っていないか」は、別々に確かめる必要がありそう。
4. 正解の表を、まだ誰も確かめていない
話しかけの文も、どの段が正解かの表も、AIが1人で書いたもの。自分はまだ、この正解の表を見て確かめていない。
余計な引き継ぎ2問が、どちらもAI自身が迷った質問だったことを考えると、正解の表の側が動く余地は残っている。
小さなモデルに指示を書くときのチェックリスト
今回の結果から、次に試すときに使う確認項目をまとめておく。どれも、今回の24問と12問、1回ずつの結果から引いたもので、ほかのモデルでも同じになるとは確かめていない。
指示文を書く前に
- モデルの文脈の上限を調べたか(今回は会話全体で4,096トークン)
- 指示文・会話の履歴・返事が、その上限に収まる見込みか
- 「中身のない一覧」を渡していないか。種類だけを教えると、中身を作られることがある
指示文を直すとき
- 問題が出たとき、決まりを足す前に、減らす・置き換える案を試したか
- 「〜しないで」を「できるのはこれだけ」に書き換えられないか
- 出力の長さに上限を付けたか。短すぎると、言い切りが先に来ることもある
- 1回に変えるのを1か所にして、何が効いたか分かるようにしているか
数えるとき
- 採点の基準に、モデルへ渡していない前提が入っていないか
- キーワードの有無だけで数えていないか。返事を一度は全部読んだか
- 「引き継いだか」と「引き継ぎのあとに作り話をしていないか」を分けて見たか
- 正解の表を、作った人以外が確かめたか
- 調整に使った問いとは別の、新しい問いでも試したか
こんな人に向いている
- スマホやMacの中で動く小さなAIモデルを、アプリの返事に使えないか試している人
- ローカルLLMに長い指示を書いたら、かえって返事が乱れて困っている人
- AIの返事を自動で数えて、良し悪しを比べようとしている人
今回は確認できなかったこと
- 話しかけはAIが書いた架空の文で、実際の会話では試していない
- 正解の表はAIが1人で作り、人の確認を通っていない
- どの版も、各問1回ずつしか答えさせていない。同じ問いでの揺れは測っていない
- 時間はMac(Apple M5)での値で、iPhoneでは測っていない。振り分けの時間はMacの固定回線での往復込み
- 試した決まりの言い回しは、それぞれ1つだけ。別の書き方なら効く可能性は残っている
- 「深い応答」の段は作っておらず、引き継いだ先の返事は試していない
- 相槌の候補を振り分けと同じ問い合わせに入れた形の時間は測っていない(約0.89秒が相槌のあとに隠れるのは見込み)
- 新しい12問で流れた判断の質問を、どうすれば拾えるかはまだ分かっていない
まとめ
小さなモデルに返事を任せようとして、うまくいかない場面に決まりを足していった。そのたびに、遅くなる、止まらなくなる、中身を作る、雑談が汚れる、と別のところが崩れた。
直ったのは、出力に上限を付けたときと、禁止の決まりを「できることの列挙」に置き換えたときだった。どちらも、指示を増やす方向ではなく、減らす方向の変更になる。
| 項目 | 内容 |
|---|---|
| 結論 | 4,096トークンの端末内モデルでは、指示を足すほど悪化した。出力の上限220(中央値7.50秒→1.82秒)と、できることの列挙への置き換え(判断の質問の引き継ぎ6問中0→6、中央値0.54秒)で直った |
| 教訓 | 小さなモデルには、決まりを足す前に減らす・置き換えるを試す。返事を数えるときは、渡していない前提・文字列だけの集計・確認されていない正解表に気をつける |
| 対象読者 | 端末内やローカルの小さなAIモデルを試している人 |
同じ状況に陥ったときの回避策
- 決まりを1つ足したら、時間・失敗・雑談への影響も一緒に見る
- 「〜しないで」が効かないときは、「できるのはこれだけ」と許可の形に書き直す。前の決まりに足さず、置き換える
- 記録の種類だけを教えるくらいなら、渡さない
- 出力の上限は、まず付ける。そこから縮めるときは、振る舞いが崩れないか確かめる
- 返事は数える前に読む。キーワードの集計は、読み上げやおうむ返し、引き継ぎのあとの作り話を見分けられない
次に読むなら
小さなモデルを端末やPCで動かすか、月額のAIサービスに任せるかを決めるときは、費用の比べ方も一度見ておくと判断しやすい。
- LocalLLMは本当に得?Claude Pro/ChatGPT Plusと費用で比較した — 手元でAIを動かす場合と月額のサービスを使う場合を、機材の購入から含めた費用で比べられる
公式情報
- Introducing Apple’s On-Device and Server Foundation Models(Apple Machine Learning Research)(約30億パラメータ)
- Meet the Foundation Models framework(WWDC25)(30億パラメータ、2ビットに量子化)
- Max tokens for Foundation Models(Apple Developer Forums)(会話全体の上限と、超えたときのエラー)
この記事は、筆者が個人で進めている会話キャラクターの技術検証の作業記録(2026年10月11日〜12日)を基に、独自調整したAIが下書きを作成し、筆者が事実確認・編集を行った上で公開しています。試験に使った話しかけと、端末内モデルの返事に出てくる金額・日付・件数は、すべてAIが作った架空のものです。本文の説明図は、記録をもとにAIが作成しています。