課題
Xで、こんな投稿を見かけた。GoogleのEmbeddingGemma 2で、キャラクターの思い出を呼び出す仕組みを作ってみたら結果が微妙だった。そこで判断用のAI「Jev」を挟んだら、Jevがすごかった、という内容になる。
数字は書かれていない。気になったのは、「どこが微妙で、Jevは何をよくしたのか」だった。
ちょうどこのブログには、公開中の記事が116本ある。読者の質問に合う記事を探す仕組みとして、自分のデータで同じ組み合わせを試せば、数えて確かめられる。
解決できるようにすること
「埋め込みモデルで候補を拾い、判断モデルで並べ替える」という2段構えについて、それぞれの段が何に効き、何に効かないかを判断できるようにする。あわせて、手元のMacで試すときの手順、かかった時間と費用もまとめる。
先に結論
公開中の記事116本と、あらかじめ決めた質問12問で比べた。
- EmbeddingGemma 2だけでも、12問すべてで1本目が正解だった。引っかけの質問も外さなかった
- Jevで並べ替えると、上位3本に入った正解の割合が81%から90%に上がった。効いたのは1本目ではなく、2本目・3本目の正解を引き上げるところだった
- Jevは「関係ある確率」を返す。正解の記事は中央値で90%、それ以外は16%で、関係ない記事を出さない線を引ける
- 1段目で拾えなかった正解は、2段目では戻らない。記事を短い文に分けて試すと、Jevが引っかけにかかる場面もあった
- 費用は、Jevを120回呼んで約0.008ドル(約1円)。EmbeddingGemma 2は手元のMacで動き、外へは何も送らない
この記事でわかること
- EmbeddingGemma 2とJevが、それぞれどんなAIか
- 2段構えで、1段目と2段目がそれぞれ何に効いたか(比べた数字)
- 記事を短い文に分けると、結果がどう変わったか
- 手元のMacで試したときの準備、時間、費用
ここで、こう思う人もいるかもしれない。
「判断モデルを挟めば、検索の精度はぐっと上がるんじゃないの?」
今回の結果を見る限り、1本目の精度はもともと高く、Jevで変わらなかった。変わったのは、その下の順位と、「どこから先は関係ない」と言い切れる線のほうだった。
公式発表で分かったこと
EmbeddingGemma 2
EmbeddingGemma 2は、Google DeepMindが2026年10月6日に公開した埋め込みモデルになる。埋め込みモデルは、文章を「意味を表す数字の並び(ベクトル)」に変えるAIで、意味の近い文章どうしは数字も近くなる。これを使うと、言葉が一致しなくても、意味の近い記事を探せる。
公式の開発者向けガイドとモデルの説明ページによると、主な特徴は次のとおり。
| 項目 | 公式の記載 |
|---|---|
| 扱えるもの | 文章(コードを含む)、画像、音声、動画を同じ数字の空間に変える |
| 大きさ | 全体で7.4億パラメータ。文章だけなら2.7億 |
| 数字の長さ | 768。512・256・128に縮めても使える |
| 一度に読める長さ | 8,192トークン |
| ライセンス | Apache 2.0。ダウンロードに申請はいらない |
| 動かし方 | sentence-transformers、Ollama、MLX、LM Studioなど |
公式ガイドでは、使い道としてRAG(AIに資料を探させて答えさせる仕組み)やコード検索が挙げられている。128の長さは、並べ替えの前の候補しぼりに向く、とも書かれていた。
Jev
Jevは、TypeSafeという会社のAIで、文章を書かずに「決めた選択肢のどれに当たるか」を確率つきで返す。このブログでも以前、Jevを始める前の確認手順を書いている。
公式ドキュメントには、検索結果の並べ替え(リランキング)の例がある。候補1件ずつに「この候補は質問に当たるか」を聞き、返ってきた確率の高い順に並べ直す、という使い方になる。
| 項目 | 公式の記載 |
|---|---|
| 使い方 | APIで呼ぶ |
| 料金 | 入力100万トークンあたり0.042ドル。出力は無料 |
| 提供状況 | 早期アクセス中 |
| データの扱い | 入力をAIの学習・微調整に使わない。サービスは米国でホストされる |
実際に試した環境と方法
試したのは2026年10月9日、MacBook Air(Apple M5、メモリ16GB)になる。
試し方とスクリプト、後で紹介する画面は、AIに組み立ててもらった。自分は、何を材料にするか、ダウンロードしてよいか、質問と正解をどう決めるかを判断している。
準備したもの
- EmbeddingGemma 2: Hugging Faceの公式ページから取得した。モデルは約1.4GB
- 動かすための部品: Pythonの部品(sentence-transformers 6.1、PyTorchなど)を専用の環境に入れた。合計で約900MBになり、思っていたより大きかった
- JevのAPIキー: 以前の検証で発行していたものを使った
最初は、モデルの読み込みで「画像処理の部品が無い」というエラーが2回出た。文章しか使わないつもりでも、読み込みには画像用の部品(pillow、torchvision)が要った。
材料と質問
材料は、このブログで公開中の記事116本にした。公開済みの文章だけなので、Jevへ送っても困らない。
質問は、読者が聞きそうなものを12問用意した。
- 言葉がそのまま合う質問(例:Macで無料の画像生成を始めたい)
- 言い換えた質問(例:AIの答えをそのまま信じていいのか不安)
- 引っかけの質問(例:ChatGPTが前の会話を覚えているか確かめたい。ほかのAIの「記憶」の記事も拾いやすい)
質問ごとの正解の記事は、AIが案を出し、自分が確認して決めた。結果を見る前に決めている。
比べ方
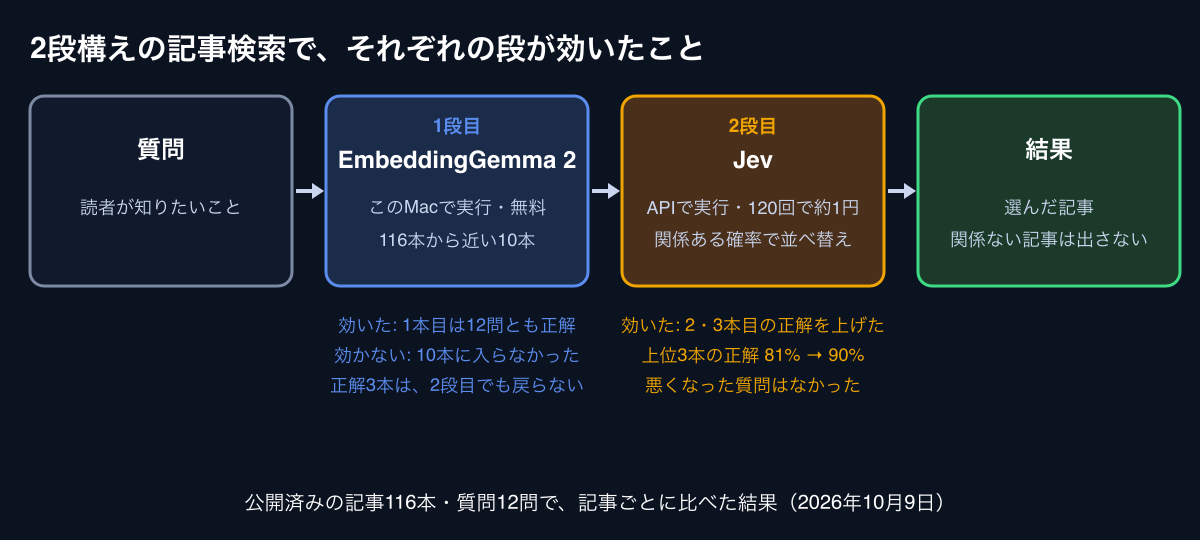
- 116本の記事を、EmbeddingGemma 2でベクトルにしておく(このMacで約106秒)
- 質問もベクトルにして、近い記事を10本拾う(1段目)
- 10本それぞれについて、Jevに「この記事は、この質問の人が探している記事か」を聞く(2段目)
- Jevの確率の高い順に並べ直し、1段目の順位と比べる
参考の投稿は、思い出をQdrantというデータベースに入れていた。今回は116本と少ないので、データベースは使わず、メモリの中で近いものを探している。
記事ごとに比べた結果
| 1本目が正解 | 上位3本に入った正解の割合 | |
|---|---|---|
| EmbeddingGemma 2だけ | 12問中12問 | 81% |
| Jevで並べ替え | 12問中12問 | 90% |
1本目は、並べ替えの前から全部当たっていた。参考の投稿の「微妙」は、記事の題名がはっきりしている今回の材料では起きなかった。
Jevが効いたのは3問で、どれも2本目・3本目の正解を上に引き上げている。
- 「AIの答えをそのまま信じていいのか不安」では、「確認に使ったAIが、存在しない間違いを見つけてきた」記事が、9位から3位に上がった
- 「Macで無料の画像生成を始めたい」では、Draw Thingsを試した記事が4位から3位に上がった
- 「同じ設定なのに動画の結果が毎回変わる」では、Seedを変えた記事が4位から3位に上がった
順位が下がった正解はなかった。
もう1つ分かったのは、Jevの確率の分かれ方になる。正解の記事は中央値90%(いちばん低くて53%)、正解でない記事は中央値16%だった。埋め込みの「近さ」の数字は、正解の記事が0.70〜0.82、正解でない記事が0.64〜0.77で、0.70〜0.77のあいだは重なっている。これだと、どこで線を引けばいいかが分かりにくい。Jevの確率なら、「50%より下は出さない」という線が引ける。
一方で、正解23本のうち3本は、1段目の10本に入らなかった。Jevは渡された10本を並べ替えるだけなので、ここは直せない。
同じ比較をもう1回すると
Jevの確率は、呼ぶたびに少し変わる。同じ比較をもう1回したところ、確率の差は中央値で0.01、最大で0.07だった。10本の並び順は12問中8問で入れ替わったが、上位3本の顔ぶれが変わったのは1問だけで、正解の割合は2回とも同じだった。
時間と費用
| 1問あたりの時間 | 費用 | |
|---|---|---|
| 1段目(このMac) | 約0.09秒 | 0円 |
| 2段目(Jev、10件を同時に) | 約0.5秒 | 120回・約19万トークンで約0.008ドル |
記事を短い文に分けて比べた結果
参考の投稿は、短い思い出がたくさんある状態だった。記事は題名がはっきりしていて、探しやすすぎたのかもしれない。
そこで、記事を段落ごとに969個の短い文(中央値393字)に分け、題名を付けずにベクトルにして、同じ12問で比べた。各記事の最初の文には、本文の見出しとして題名が入っている。
| 1つ目の文が正解の記事から | 上位3つの文が正解の記事から来た割合 | |
|---|---|---|
| EmbeddingGemma 2だけ | 12問中11問 | 72% |
| Jevで並べ替え | 12問中11問 | 83% |
短い文でも、Jevは上位を関係のある文でそろえる方向に効いた。良くなったのは5問になる。
一方で、Jevを挟むと結果が下がった質問が2問あった。中身を見ると、性質が違った。
- 「ストアの審査で落とされたときの話」では、1つ目の文が正解の記事から外れた。Jevが1位にしたのは、正解に入れていなかった記事の「App Storeの審査で却下された経験があった」という一節だった。質問に合っていて、正解を決めるときに拾い漏らしていた記事になる
- 引っかけの「ChatGPTが前の会話を覚えているか確かめたい」では、上位3つの文のうち正解の記事から来たものが2つから1つに減った。JevがChatGPTの検索機能の文や、Sakana Chatの記憶の文を上に上げてしまった。1段目では正解の文が1位だったので、短い文だけを見せると、Jevも引っかけにかかることがあった
作った画面「PAGEの書棚」
参考の投稿にならって、結果を見られる画面も作った。このMacの中だけで動く画面で、公開はしていない。
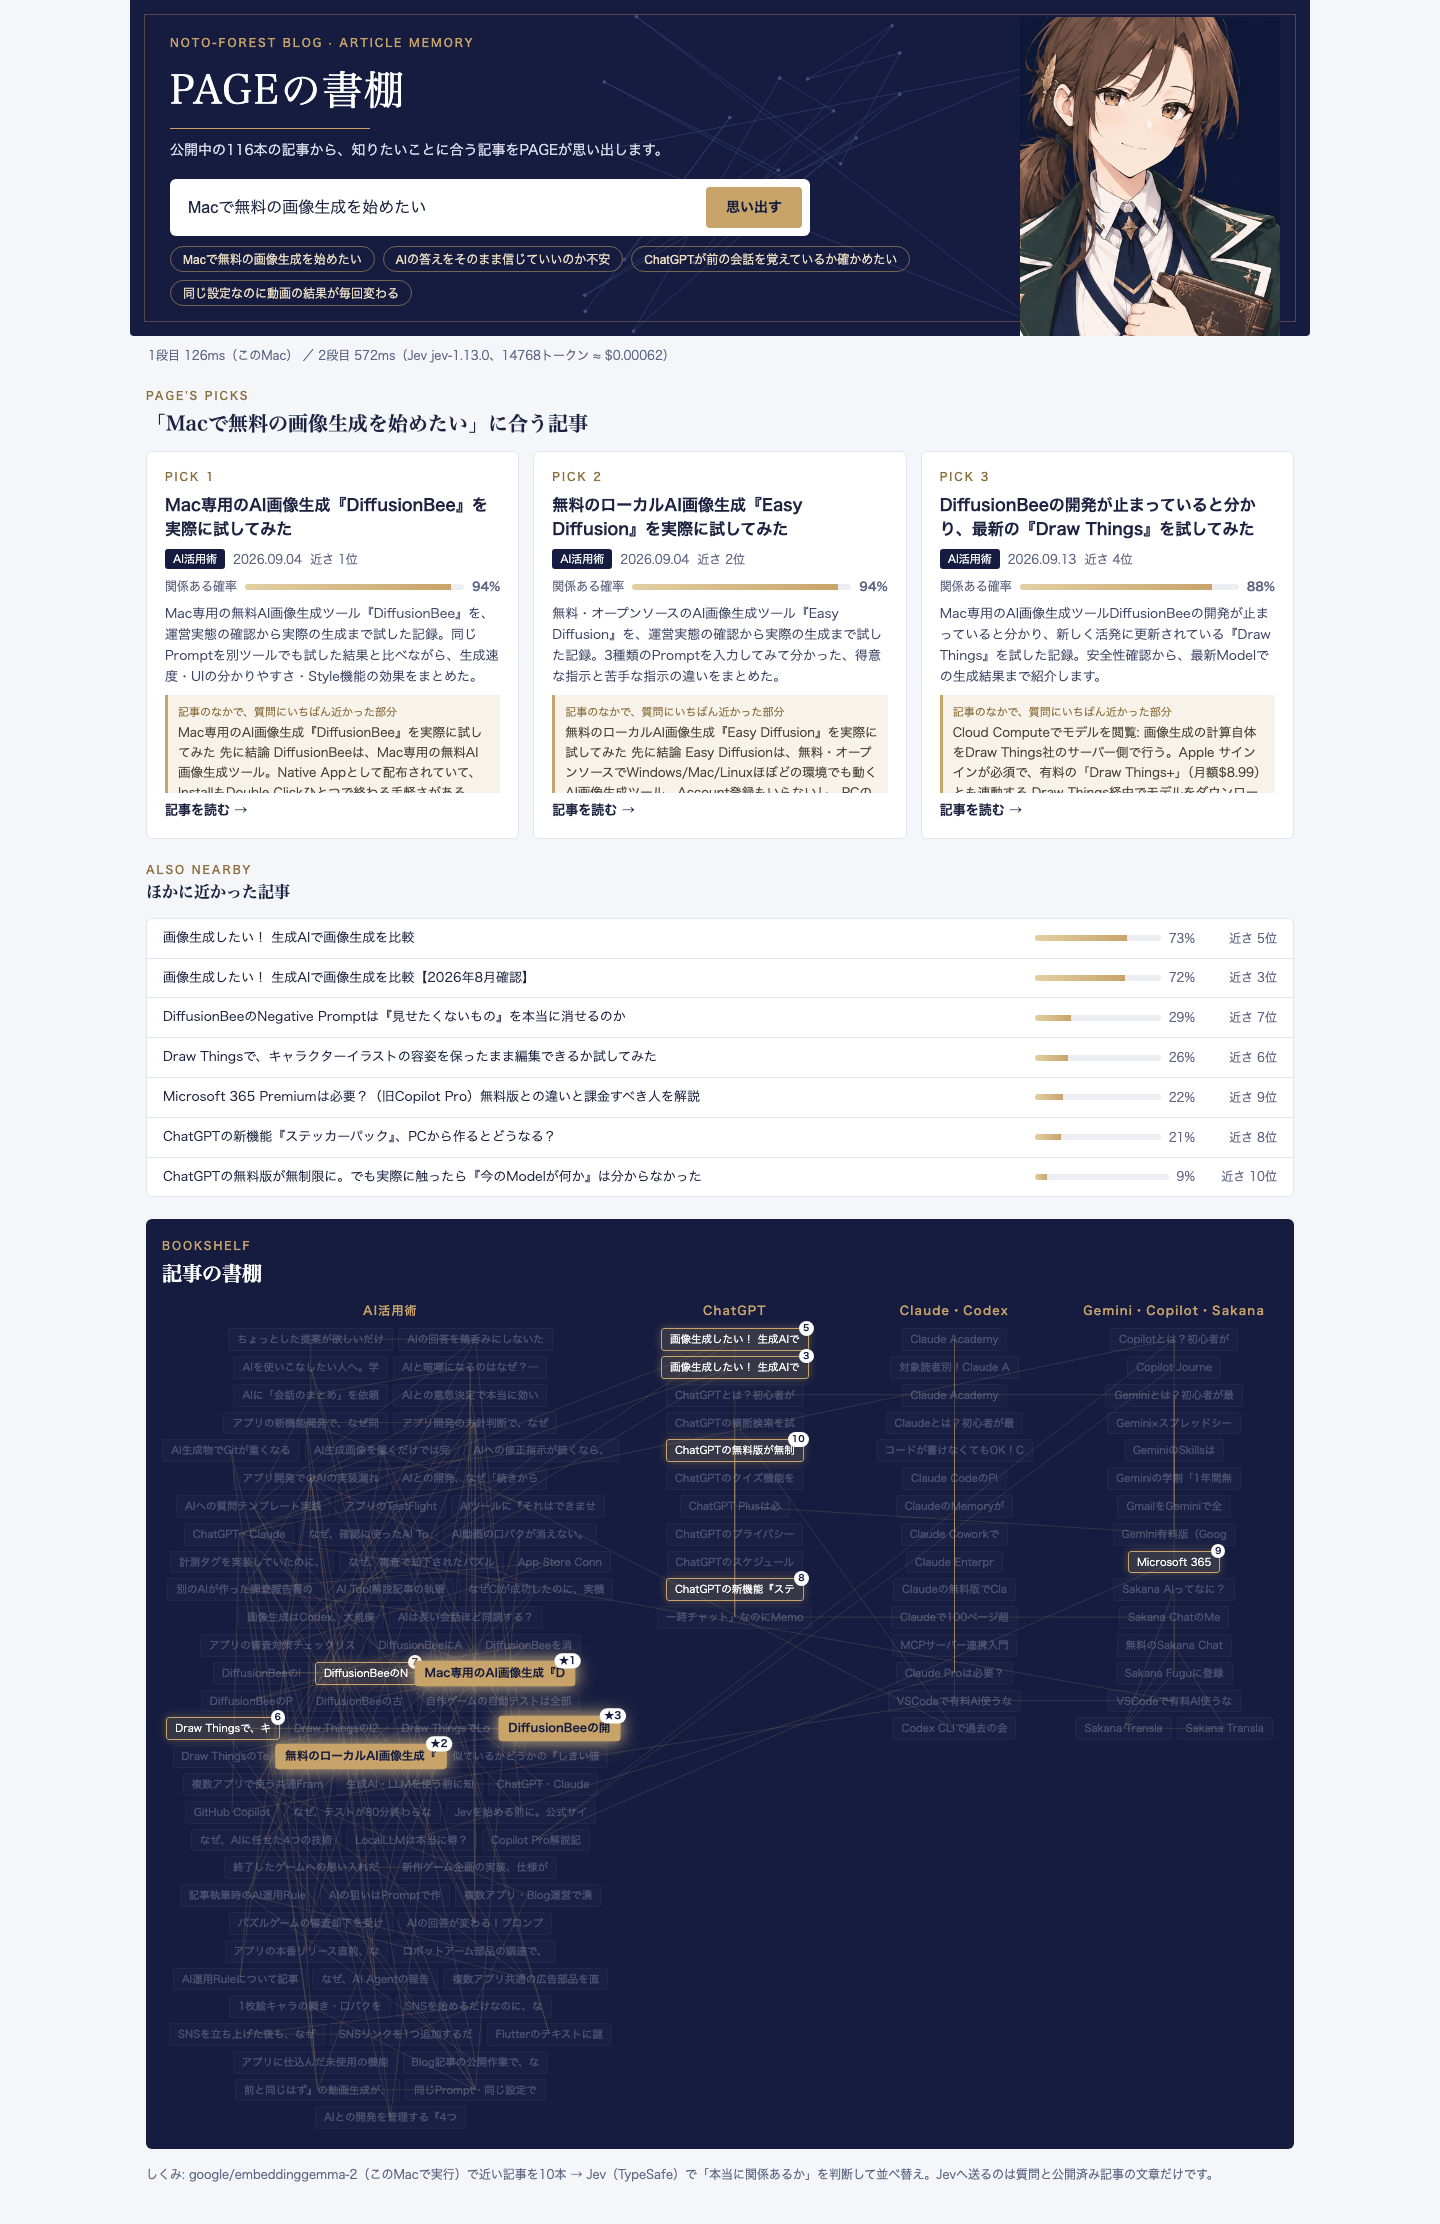
質問を入れると、1段目で拾った10本のうち、Jevが選んだ記事をカードで出す。カードには、関係ある確率、要約、記事のなかで質問にいちばん近かった部分が入る。画面の下には、記事どうしを似ている順に線でつないだ「書棚」の図があり、拾った記事が光る。
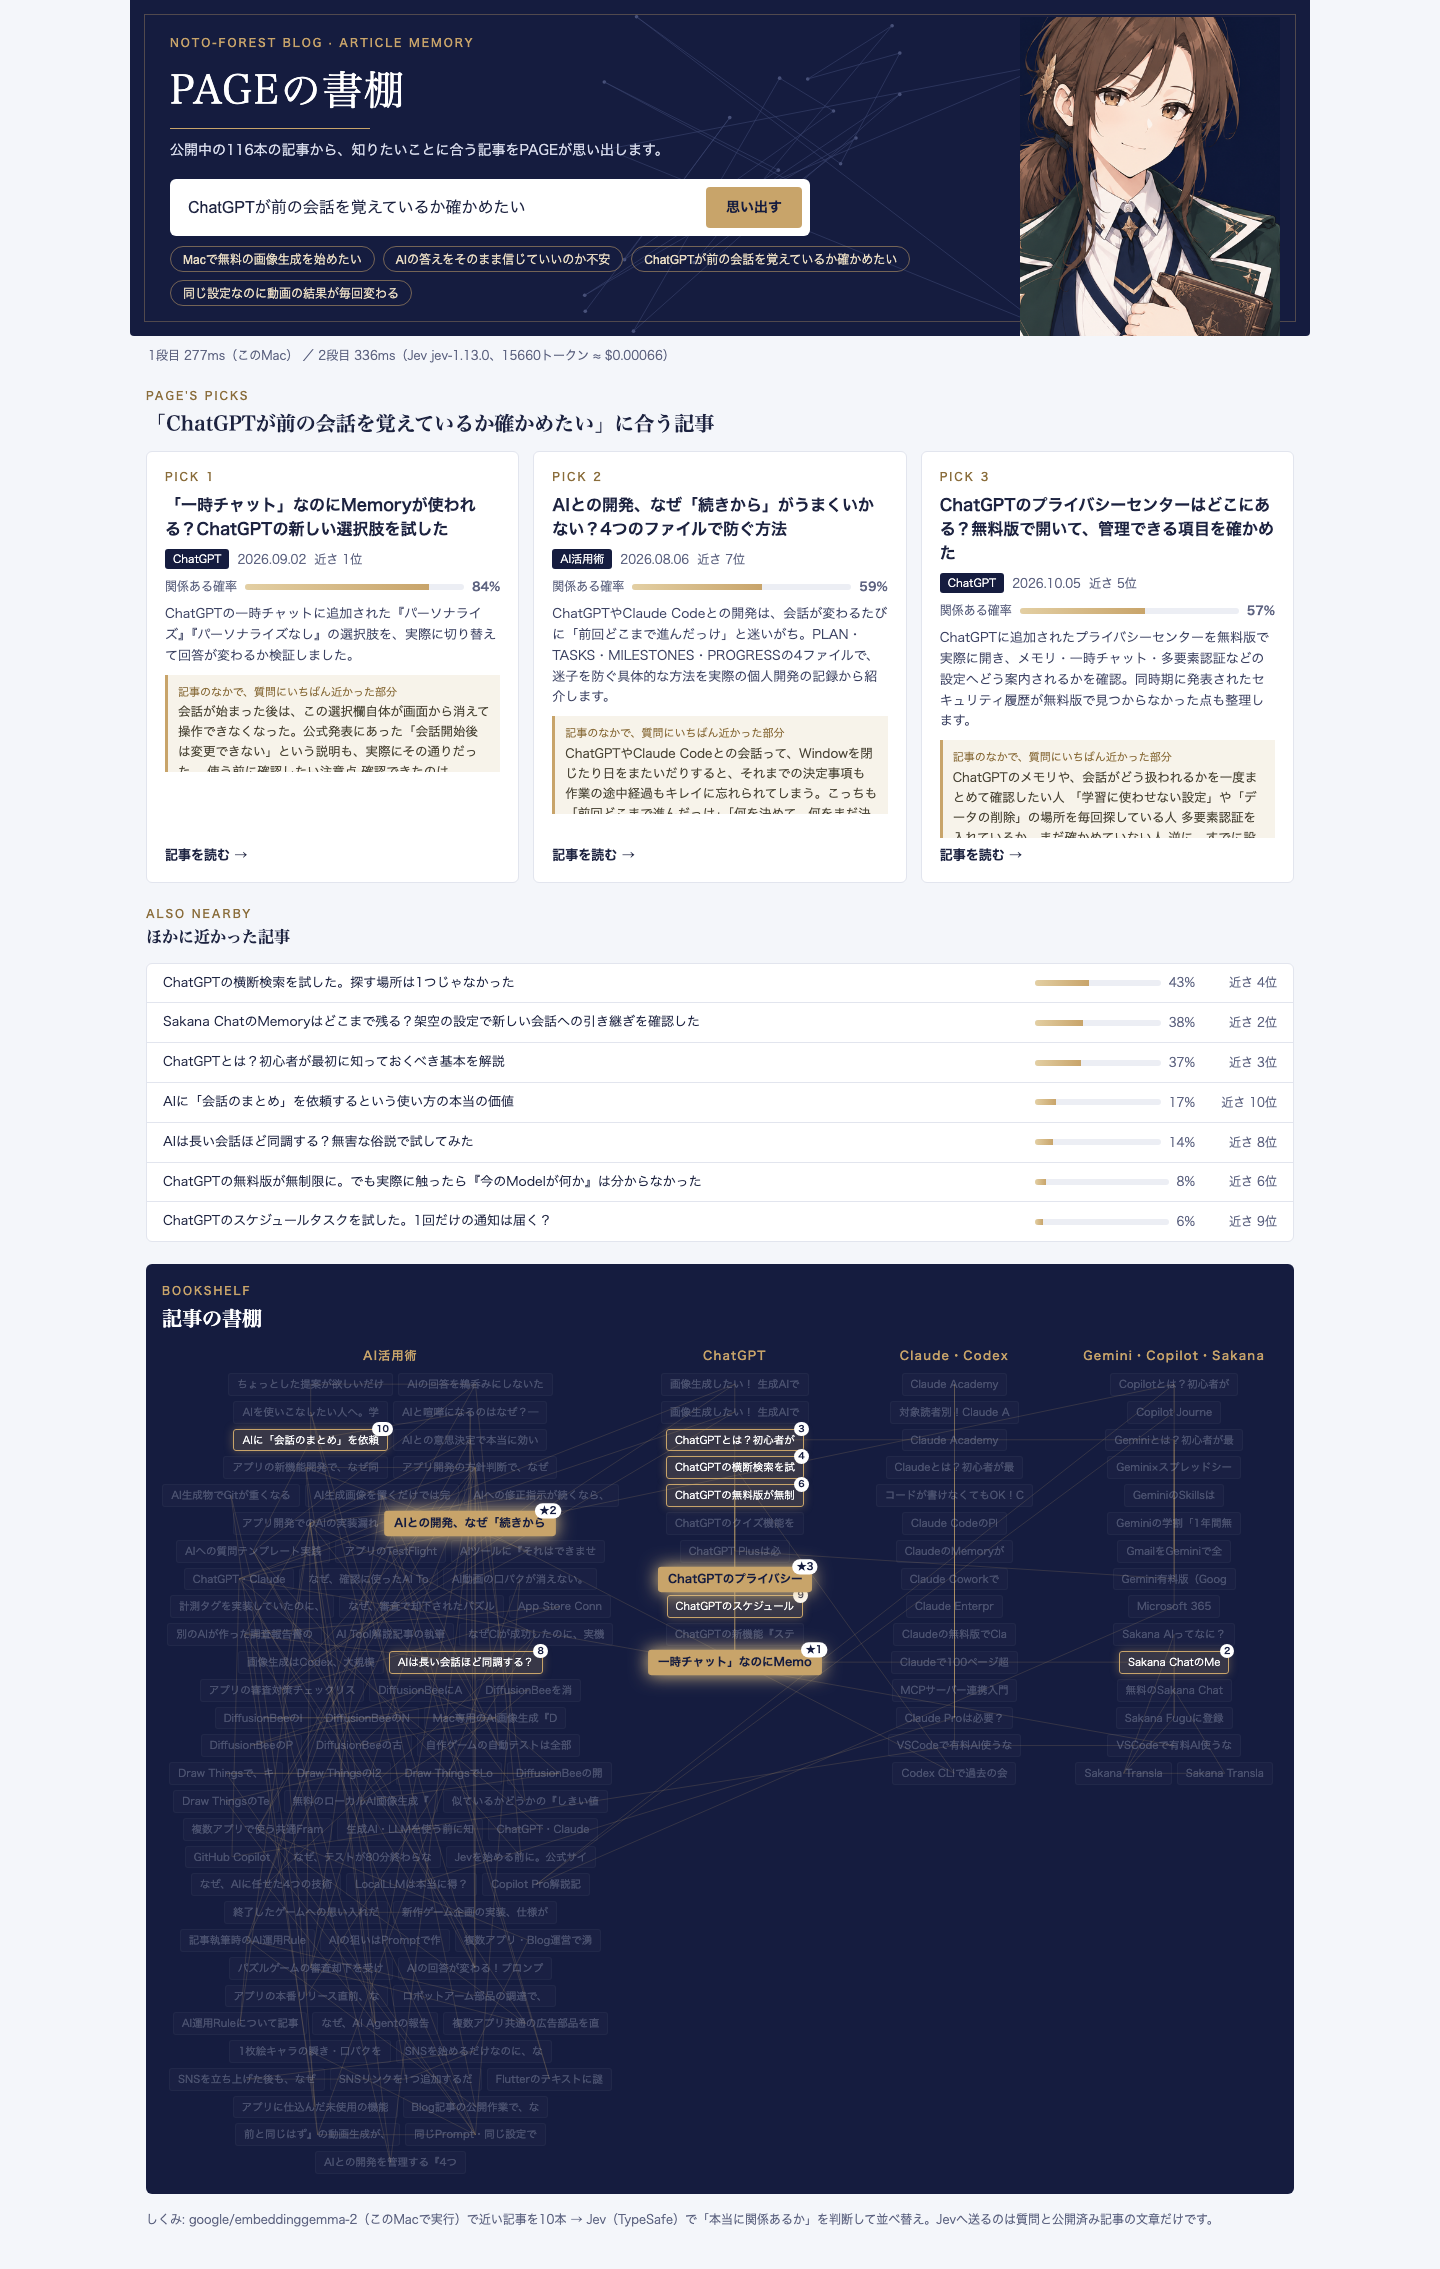
引っかけの質問では、1本目は正しく選ばれた。ただ、2本目・3本目には、記憶の話ではない記事も50%台で並んでいる。50%という線は、ぎりぎりの記事も通してしまうことが分かる。
画面では、1段目に0.1〜6.5秒かかり、時間がばらついた。比べるための実行では約0.09秒だったので、画面側で何かが遅くなっている。原因はまだ調べていない。
期待どおりだった点と、うまくいかなかった点
期待どおりだったのは、EmbeddingGemma 2が手元のMacで素直に動いたことになる。116本をベクトルにするのに約2分、質問1つは0.1秒もかからない。外へ何も送らずに、記事の検索ができた。
意外だったのは、1本目の精度がもともと高く、Jevで変わらなかったこと。参考の投稿のように「埋め込みだけだと微妙」になるかと思っていたが、記事単位ではそうならなかった。
うまくいかなかったのは、次の3点になる。
- 1段目で拾えなかった記事は、Jevを挟んでも出てこない
- 短い文だけを見せると、Jevも引っかけにかかる
- 正解の付け方に漏れがあり、Jevのほうが正しかった場面があった。比べる側の正解も、完ぺきではない
どんな人に向くか
この2段構えが向いているのは、次のような人になる。
- 自分のブログやメモから、関係する記事を探す仕組みを作りたい人
- 「関係ない結果は出さない」線を引きたい人
- 数十〜数百件程度のデータで、まず手元で試してみたい人
逆に、1本目さえ当たればいい用途なら、EmbeddingGemma 2だけでも十分かもしれない。今回の材料では、そうだった。
外部へ送れないデータを扱う場合は、Jevは使えない。Jevは米国のサーバーで処理されるので、送るのは公開してよい文章に限ったほうがいい。
今回は確認できなかったこと
- 質問は12問だけで、正解はAIの案を自分が確認して決めた。数が少なく、正解にも漏れがあった
- 日本語のブログ記事以外(英語、画像、音声)は試していない
- 1段目の候補を10本より増やした場合や、短い文の検索と記事の検索を組み合わせた場合
- 画面で1段目が遅くなる原因
- 参考の投稿と同じ「思い出」のようなデータでの比較
現時点の判断
| 項目 | 内容 |
|---|---|
| 結論 | EmbeddingGemma 2だけで1本目は12問とも当たった。Jevは2・3本目の正解を引き上げ、関係ない記事を出さない線を引ける。拾えなかった記事は戻らない |
| 費用 | EmbeddingGemma 2は手元のMacで無料。Jevは120回で約0.008ドル |
| 注意 | 短い文だけを見せると、Jevも引っかけにかかる。Jevへ送るのは公開してよい文章だけにする |
| 確認日 | 2026-10-09(MacBook Air M5、EmbeddingGemma 2、Jev 1.13.0) |
この画面「PAGEの書棚」は、まだ直したいところがある。拾い漏れを減らす工夫などを試したら、その経過は別の記事にまとめるつもりでいる。
同じことを試すときのポイント
- 正解は、結果を見る前に決めておく。見てから決めると、比べ方が甘くなる
- 1段目の候補に入らなかったものは、2段目では戻らない。まず1段目で拾えているかを確かめる
- 判断モデルの確率で線を引くときは、ぎりぎりの結果がどれくらい通るかを、実際の質問で見ておく
- 文章だけを使う場合でも、モデルの読み込みに画像用の部品が要ることがある
次に読むなら
Jevの公式サイトの見分け方と、始める前の確認はこちら。名前の似た非公式のサイトもあるので、試す前に読んでおくと安心できる。
埋め込みで「似ている」をどこから判断するかを、実際に測って決めた記録はこちら。
公式情報
- EmbeddingGemma 2: The Developer Guide(Google Developers Blog)
- EmbeddingGemma 2(Google Blog)
- google/embeddinggemma-2(Hugging Face)
- TypeSafe
- TypeSafe API Reference
- Reranking cookbook(TypeSafe Docs)
- TypeSafe Privacy Policy
この記事の紹介動画
この記事の内容を、ブログの案内役のPAGEと、SNSを担当しているLEAFが動画で紹介している。
この記事は、2026年10月6日のEmbeddingGemma 2の公式発表、TypeSafeの公式ドキュメント、2026年10月9日の実践記録を基に、独自調整したAIが下書きを作成し、筆者が事実確認・編集を行った上で公開しています。